Graylog: Ein kleines How to Pipelines
Geschätzte Lesezeit: 5 Minuten
Pipelines sind eine unglaublich mächtige Art Daten in Graylog zu verarbeiten. Die Verarbeitung kann dabei verschiedene Bereiche umfassen:
- Parsing: alles was damit zu tun hat, Logs besser lesbar zu machen und ihre Inhalte in verschiedene Felder aufzusplitten
- Enrichment: alle möglichen Daten basierend auf den Informationen in einem Log an das Log hinzuzufügen
- Routing: Daten in einen oder mehrere Streams zuzuordnen oder aus bestehenden Streams zu entfernen
Piplines und Rules
Pipelines sind Strukturen, welche an Streams angeschlossen werden. Wird eine Nachricht in einen Stream zugewiesen, so werden die dazu gehörigen Pipelines in Gang gesetzt die Nachricht zu verarbeiten. Innerhalb von Pipelines gibt es verschiedene Stages, welche eine ganzzahlige Nummerierung haben. Beginnend mit kleinen Werten werden die Logs nacheinander von den Stages verarbeitet. Auch negative Werte sind für Stages möglich, jedoch nicht üblich.
Innerhalb einer Stage befinden sich eine oder mehrere Rules, welche (potenziell parallel) ausgeführt werden. Daher sind bei aufeinander aufbauenden Rules auch aufeinander folgende Stages zu verwenden. Beispiel: eine Regel extrahiert das Feld source_ip, eine andere Regel macht auf diesem Eintrag einen reverse DNS Lookup.
Stages haben auch eine Bedingung, ob eine Lognachricht in weiteren Stages verarbeitet werden soll:
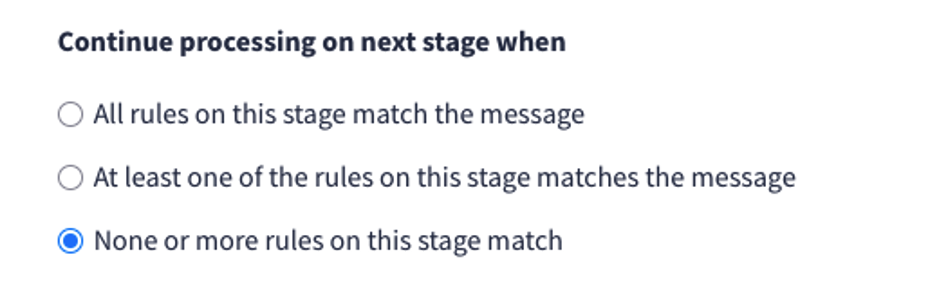
Wir nutzen diese Art von Abbruch einer Verarbeitung nicht, da wir die Entscheidung darüber, ob eine Rule ausgeführt wird, nicht davon abhängig machen, ob eine Logzeile an einer Rule „vorbei kommt“. Wir bilden diese Logik über die Bedingungen in den Rules ab. Daher ist der erste Klick beim Anlegen einer neuen Stage erst einmal die Einstellung auf „None or more rules on this stage match“ umzustellen.
Struktur von Rules
Wir ziehen die Text-Regeln dem graphischen Editor vor, da wir hier einfacher mit Copy und Pase aus unseren Vorlagen arbeiten können. Eine Regel hat
- Einen Namen in der ersten Zeile zwischen den Anführungszeichen
- Eine Bedingung zwischen dem „when“ und dem „then“
- Und keine oder mehrere Zeilen mit Instruktionen
- Kommentare können mit einem doppeltem Slash begonnen werden
Routingstruktur von Pipelines
Werden Logs durch einen Graylog-Input empfangen, so werden diese erst einmal im Stream „All messages“ bzw. „Default Stream“ abgelegt (je nach Graylog Version). Dieser Stream ist in erster Linie ein Sammelsurium an Logs, welche aufgeräumt werden müssen.
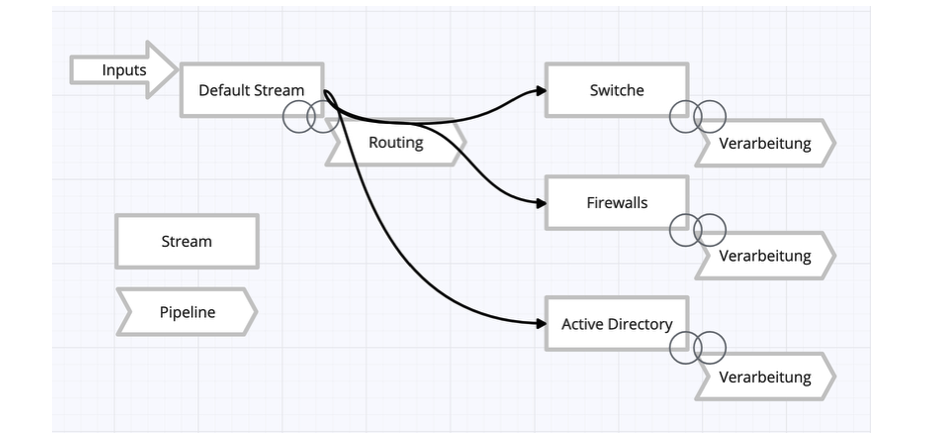
Wir sortieren Logs in der Regel nach Thema: Firewall Logs in einen Stream für Firewall Logs, Windows Active Directory in einen Stream für Windows Active Directory, DNS Queries in einen Stream für DNS Queries und so weiter. Da wir, wenn irgend möglich, einer Art von Logquelle über einen eigenen Input empfangen, können wir das Routing sehr elegant über die ID des Inputs steuern. Jeder Input hat eine kleine ID, welche auf der Seite der Inputs steht.
Mittels dieser ID lassen sich Routing Regeln spezifizieren:
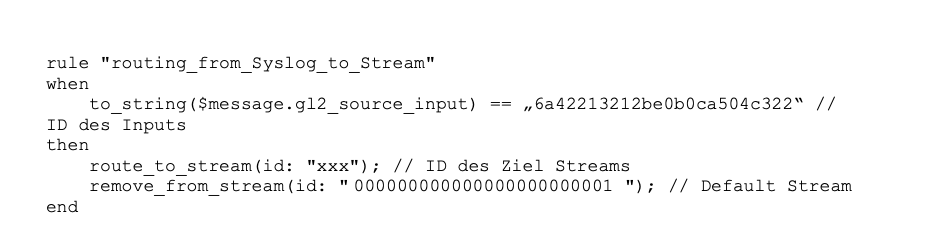
Wichtig bei dieser Regel sind zwei Eigenschaften: Erstens: Die Ziel-Streams werden mittels IDs angegeben. Diese bleiben immer gleich, auch wenn der Stream aus Nomenklatur-Gründen einmal seinen Namen ändern sollte. Zweitens: Die Bedingung überprüft ein bestimmtes Feld auf Gleichheit mit einem bestimmten String. Das geht sehr schnell und braucht kaum Ressourcen. Die ID des Ziel-Streams gibt es in der URL des Browsers beim Besuch der Übersichtsseite des Streams.
Bedingungen von Rules
Bedingungen entscheiden darüber, ob der Aufgaben-Teil einer Rule ausgeführt wird. Meisten sind es schnelle Vergleiche, welche recht wenig CPU Zeit benötigen. Bei den Bedingungen, ob eine Regel ausgeführt wird, handelt es sich immer um eine aussagenlogische Formel. Mehrere solche Bedingungen lassen sich mit AND und OR verknüpfen. Zusätzlich können Klammern verwendet werden, um einzelne Teile zu erst auszuwerten. Mit einem NOT lassen sich einzelne Bedingungen negieren. Am Ende aller Bedingungen steht kein Semikolon.
Neben der Bedingung, ob das Log aus einem speziellen Input kam gibt es einige weitere, häufig genutzte, Bedingungen. Die häufigsten sind für uns folgende:

Dies überprüft, ob eine Nachricht ein bestimmtes Feld enthält, unabhängig vom Inhalt des Feldes.

Dies Überprüft, ob in einem bestimmten Feld ein bestimmter Substring enthalten ist.
Für eine vollständige Liste aller möglichen Bedinungen, und auch Operationen im folgenden then-Teil, empfehlen wir die Graylog Dokumentation zur „Functions Reference“
Ausführender Teil von Rules
Im ausführenden Teil von Rules passiert die eigentliche Aktion, welche die Rule ausführen soll. Im Interesse einer besseren Lesbarkeit schreiben wir hier nur die Zeilen zwischen „then“ und „end“, und lassen den Rest einer Regel weg.
Grok Pattern anwenden
Häufig sollen mittels Grok Pattern Logzeilen geparsed werden, welches gut menschenlesbar sind, jedoch nicht für Maschinen. Dafür müssen Grok Pattern erstellt werden, welche diese Arbeit übernehmen. Wie Grok Pattern geschrieben werden haben wir in unserem Blogpost TOTO LINK erklärt.
In einer Pipeline werden Grok Pattern auf folgende Weise genutzt:
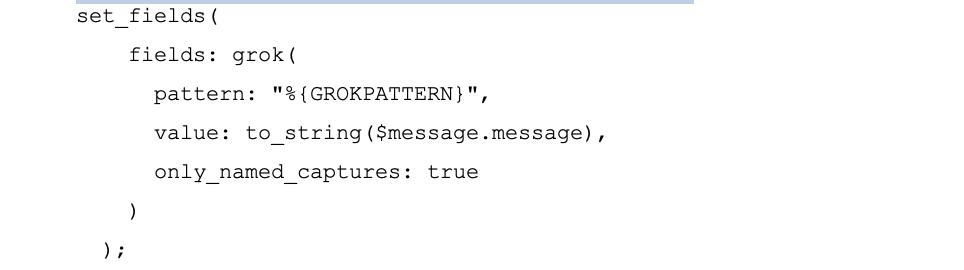
Das GROKPATTERN muss mit dem jeweiligen Pattern ersetzt werden, um das Feld „message“ der Logzeile zu verarbeiten. Soll ein anderes Feld verarbeitet werden, muss dieses entsprechend in Zeile vier adressiert werden: $message.feldname.
KV-Zerlegung
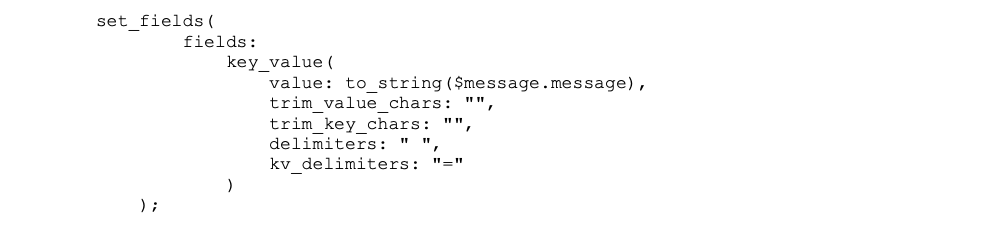
Key-Value Nachrichten enthalten Feldnamen und Feldwerte in einem bestimmten Schema. Zum Beispiel Feldname1:Feldwert1, Feldname2:Feldwert2. Um solche Nachrichten nutzbar zu machen, wird die key_value()-Funktion verwendet:
JSON
Die Zerlegung von JSON ist recht einfach:

Sowohl bei der Zerlegung von JSON, als auch bei Key-Value werden die Feldnamen der Eingangsnaricht einfach übernommen. Diese Felder sind in der Regel nicht passend zur Nomenklatur, wie sie in Graylog üblich ist. Wir empfehlen sich bei der Auswahl von Feldern an das GIM, das Graylog Information Model, zu halten. Um Felder umzubenennen, verwenden wir die rename_field()-Funktion.
Timestamps anpassen
Gelegentlich kommt es vor, dass im Syslog nur eine Genauigkeit auf die Sekunde übermittelt wird, aber im Log auch Millisekunden mit genannt werden. Da eine Sekundengenauigkeit nicht immer ausreicht ist es in diesen Fällen üblich den timestamp einmal neu zu setzen, damit die genauen Daten aus dem Log übernommen werden. Wird eine Zeit mit einem unix-Timestamp mit Millisekunden-genauigkeit angegeben, so nutzten wir diese Funktionen:

Oder bei komplizierteren Datumsformaten, welche ggf. noch angepasst werden müssen, diese Funktionen:
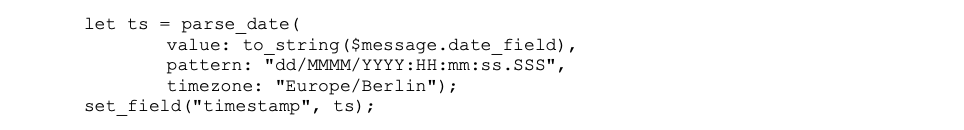
Die Variable „pattern“ wird dabei mit einem Pattern versehen, welches den String des Zeitstempels darstellt. Sind in dem String Lehrzeichen oder andere statische Zeichen enthalten, so können diese mit einzelnen Anführungszeichen eingeschlossen werden. Beispiel: „dd/MMMM/YYYY’T‘HH:mm:ss.SSSZ“. Die Belegung der verschiedenen Buchstaben für die verschiedenen Zeitangaben gibt es hier: http://www.joda.org/joda-time/apidocs/org/joda/time/format/
Anreicherung von Logs
Um Logs mittels Lookup-Tabellen anzueichern verwenden wir folgenden Funktionsaufruf:

Dabei ist geo-lookup die Lookup Tabelle im Graylog, welche genutzt werden soll. In diesem Beispiel ist es eine Tabelle für geo-lookups.
Löschen von Logs
Die Auswahl der relevanten Logs ist entscheidend, um den Speicherbedarf des Graylogs im Zaum zu halten sowie damit verbundene unnötige Kosten zu vermeiden. Sollten die Netzwerkbandbreiten keine große Rolle von der Kostenseite spielen ist es gut möglich alle unrelevanten Logs in der Verarbeitung im Graylog zu löschen. Diese werden dann nicht im OpenSearch abgelegt und verursachen damit (auch bei einer Enterprise-Lizenz) keine Kosten für Speicherplatz.
Es ist im Graylog möglich Logs auf zwei Arten einzusparen: zum einen ein Löschen des gesamten Logeintrags, sofern dieser komplett redundant ist. Ein Beispiel hierfür kann ein Log einer Firewall sein, dass ein Client auf Pot 53 zu einem DNS Server spricht. Voraussetzung dafür ist, dass ein DNS Query Log des DNS-Servers vorliegt. Das Log der Firewall kann komplett gelöscht werden, da in dem Query Log des DNS Servers auch die Informationen zum Client vorhanden sein sollten, zusätzlich jedoch auch noch die Details zum Query. Zum löschen eines gesamten Logeintrags verwenden wir die Funktion

Sollten nur einige Felder innerhalb eines Logs gelöscht werden ist dazu die Funktion
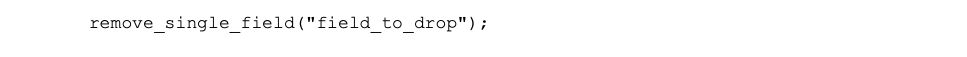
hilfreich. Das einzelne Feld wird hier entfernt, der Rest der Nachricht bleibt unverändert. Zu beachten ist: die Felder „source“, „message“ und „timestamp“ können nicht gelöscht werden. Das message-Feld kann jedoch gut mit kürzeren Strings überschrieben werden, wenn alle Informationen hieraus extrahiert wurden.
📌 Die Beiträge auf dieser Website wurden – auf Basis der NetUSE-eigenen Wissendsdatenbank – in Teilen mithilfe künstlicher Intelligenz erstellt.